
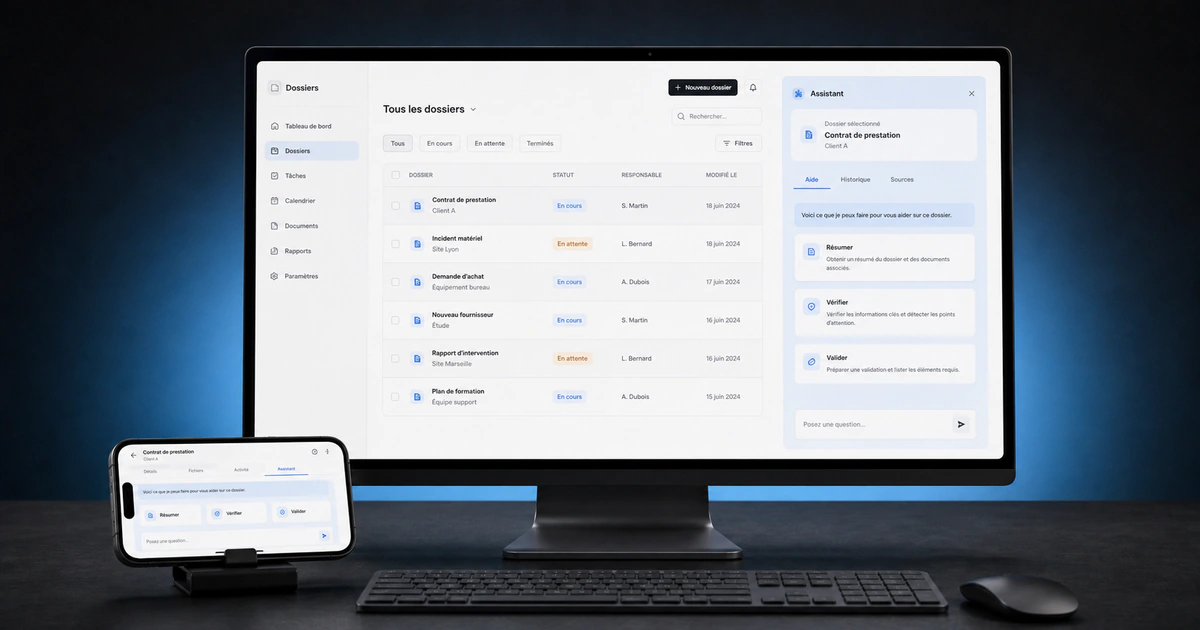
Pour intégrer l’IA dans un logiciel existant, ne branchez pas directement le prototype sur une action métier. Définissez d’abord les données qu’il peut lire, la sortie attendue, les erreurs qui imposent un refus, la personne qui contrôle le résultat et le fonctionnement sans IA. Testez ensuite sur des cas représentatifs, puis ouvrez l’usage par étapes. L’automatisation ne vient qu’après des preuves obtenues dans le vrai parcours.
Repères et sources vérifiés en septembre 2026. Cette méthode doit être adaptée aux données, aux risques, aux utilisateurs et aux obligations propres à chaque projet.
Un prototype ne possède pas encore les garanties du logiciel
Un prototype répond à une question limitée : un modèle peut-il produire un résultat intéressant sur quelques exemples ? La personne qui fait la démonstration choisit souvent les entrées, corrige les formulations et relance discrètement un essai. Ces interventions font partie de l’apprentissage, mais elles ne peuvent pas rester invisibles dans une fonctionnalité utilisée chaque jour.
Le logiciel existant doit traiter d’autres situations : un champ manque, un utilisateur n’a pas le droit de lire un dossier, le fournisseur ne répond pas, le résultat ne respecte pas le format, deux requêtes arrivent en même temps ou une mise à jour du modèle change le comportement.
Le passage à l’usage réel consiste donc moins à « améliorer le prompt » qu’à répartir les responsabilités. Le modèle produit une proposition variable. Le logiciel contrôle les accès, valide la structure, protège les actions sensibles et sait continuer sans cette proposition.
Si la tâche n’est pas encore choisie, commencez par la méthode de sélection d’un premier cas d’usage IA. Ici, nous supposons que le besoin et le prototype existent déjà.
Écrivez le contrat de passage à l’usage
Avant de développer l’interface finale, remplissez ce contrat avec la personne métier, la personne technique et le responsable du risque. Une case sans réponse est une décision à prendre, pas un détail à repousser.
| Champ | Question à trancher | Preuve attendue avant l’ouverture |
|---|---|---|
| Déclencheur | Qui lance l’IA, depuis quel écran et à quel moment ? | Un parcours décrit avec début, fin et annulation |
| Données autorisées | Quels champs et documents le modèle peut-il lire pour cet utilisateur ? | Une liste liée aux habilitations du logiciel |
| Sortie | Quel format exact doit revenir ? | Un schéma et des exemples acceptés ou refusés |
| Validation | Quelles règles déterministes peuvent vérifier la sortie ? | Des tests sur le format, les valeurs et les références |
| Action | La sortie suggère-t-elle, prépare-t-elle ou exécute-t-elle une action ? | Une frontière d’écriture explicite |
| Supervision | Qui relit, que voit cette personne et comment refuse-t-elle le résultat ? | Un écran de contrôle testé avec les utilisateurs |
| Repli | Que se passe-t-il si l’IA est lente, indisponible ou incohérente ? | Un parcours sans IA et un message compréhensible |
| Observation | Quels éléments permettent de diagnostiquer une erreur sans conserver trop de données ? | Des événements, versions et durées de conservation documentés |
| Responsable | Qui suit les incidents, les coûts et les changements de modèle ou de consigne ? | Un nom, une alerte et une procédure de désactivation |
Ce contrat n’impose pas une technologie. Il peut conduire à une API externe, un modèle hébergé par l’entreprise, une fonction limitée de classement ou une décision de ne pas intégrer l’IA. Son intérêt est de rendre le changement de fournisseur possible sans redéfinir tout le parcours.
Gardez les droits et les règles métier hors du modèle
Le modèle ne doit pas décider seul qu’un utilisateur peut consulter un dossier ou déclencher une écriture. Le logiciel connaît déjà la session, le rôle, le périmètre de l’organisation et les validations requises. Il doit appliquer ces règles avant de préparer les données envoyées à l’IA, puis à nouveau avant toute action issue de la réponse.
Trois frontières réduisent le risque :
- Contexte minimal : ne transmettre que les champs nécessaires à la tâche, après le contrôle d’accès habituel.
- Sortie non fiable par défaut : traiter le texte, le JSON ou l’appel proposé comme une entrée externe à valider, jamais comme une instruction privilégiée.
- Permissions bornées : exposer des fonctions précises et réversibles. Une fonction « préparer un brouillon » ne doit pas devenir « envoyer un message » par simple consigne.
L’OWASP nomme « excessive agency » le risque créé lorsqu’un système fondé sur un modèle reçoit trop de fonctions ou de permissions et peut effectuer une action dommageable après une sortie inattendue ou manipulée. La réponse ne tient pas dans une phrase magique ajoutée au prompt : elle se trouve dans les droits réels, les validations et la confirmation demandée avant l’action.
La CNIL recommande de combiner la sécurité logicielle classique et les risques propres à l’IA, notamment pour les habilitations, la maintenance et la journalisation. Si cette cartographie révèle que les accès ou les responsabilités du logiciel sont déjà confus, il peut être préférable de stabiliser l’existant avant d’ajouter une nouvelle capacité.
Évaluez le système sur la tâche complète
Une sortie qui « semble bonne » ne suffit pas, car une fonctionnalité IA reste variable. L’évaluation doit couvrir le modèle, les données préparées par le logiciel, les règles de validation et l’action proposée à l’utilisateur.
Constituez un jeu de cas représentatifs à partir d’exemples autorisés : cas fréquents, informations manquantes, formulations inhabituelles, erreur coûteuse et entrée volontairement trompeuse. Pour chaque cas, notez ce qui doit être exact, ce qui peut varier et ce qui impose un refus. Une personne métier doit pouvoir expliquer la note avec les mêmes critères qu’une autre personne.
Le guide d’évaluation d’OpenAI recommande des tests propres à la tâche, proches de la distribution réelle, nourris par les journaux et recalibrés avec du jugement humain. Cette documentation vient d’un fournisseur ; le principe reste à mettre en œuvre avec l’outil d’évaluation adapté au projet.
Ne cherchez pas un score universel. Pour un classement interne, une erreur corrigée en un clic n’a pas le même poids qu’une mauvaise action sur un paiement. Le seuil dépend du coût de l’erreur, du temps de contrôle et de la possibilité d’annuler.
Ouvrez l’usage en quatre niveaux
Le niveau suivant est débloqué par une preuve, pas par la fin d’un sprint.
| Niveau | Ce que fait l’IA | Ce qui reste sans effet | Preuve pour avancer |
|---|---|---|---|
| Test hors ligne | Traite un jeu de cas figé | Aucun utilisateur ni donnée courante n’est touché | Les critères et les erreurs bloquantes sont documentés |
| Mode miroir | Calcule sur des cas réels autorisés sans montrer ni appliquer la sortie | Le parcours habituel reste la seule source d’action | Les écarts sont compris sur une période représentative |
| Assistance contrôlée | Affiche une proposition qu’une personne accepte, corrige ou refuse | Aucune écriture sensible ne part sans décision humaine | Les corrections, refus, incidents et délais de revue sont observables |
| Automatisation bornée | Exécute seulement une action précise dans des conditions vérifiées | Les cas ambigus ou sensibles reviennent au parcours humain | Les critères d’arrêt et le retour au niveau précédent ont été testés |
Le mode miroir, parfois appelé shadow mode, permet d’observer ce que le système aurait proposé sans modifier le travail réel. Il révèle les écarts liés aux données courantes avant d’exposer une suggestion aux utilisateurs.
Le NIST AI RMF recommande de tester avant le déploiement, d’évaluer dans des conditions proches de l’usage et de suivre le comportement en production. Il prévoit aussi la possibilité de retirer ou désactiver un système dont les résultats sortent du cadre prévu.
Prévoyez quatre familles de défaillances
« Une erreur s’affiche » ne constitue pas un mode dégradé. Chaque famille appelle une réponse différente.
| Défaillance | Exemple | Comportement attendu |
|---|---|---|
| Technique | délai dépassé, quota atteint, fournisseur indisponible | abandon contrôlé, reprise limitée ou retour au parcours sans IA |
| Structurelle | champ absent, JSON invalide, référence inconnue | rejet automatique avant affichage ou écriture |
| Métier | réponse plausible mais contradictoire avec le dossier | signalement, correction ou refus par une personne compétente |
| Autorisation | tentative d’accès ou d’action hors du rôle de l’utilisateur | blocage par le logiciel, événement de sécurité et aucune extension de droit |
Les reprises automatiques doivent éviter les doublons. Si l’IA prépare une opération et que le réseau coupe après l’envoi, le logiciel doit savoir si l’opération a déjà été enregistrée. Pour une action sensible, mieux vaut demander une confirmation que deviner.
Exemple rempli : ajouter l’IA à un logiciel de support B2B
L’exemple suivant est fictif. Il montre la méthode ; il ne décrit ni un client ni un résultat de Klaapp.
Une PME utilise déjà un logiciel de support. Chaque ticket contient le message, le compte client, le produit concerné, la priorité et l’historique autorisé. Le prototype classe correctement plusieurs demandes et rédige des réponses convaincantes. Trois options sont envisagées : envoyer automatiquement, afficher seulement un brouillon, ou ne classer que la catégorie.
Les contraintes changent la décision : certains comptes ont des engagements contractuels particuliers ; une priorité critique déclenche une astreinte ; les pièces jointes peuvent contenir des données confidentielles ; l’équipe doit pouvoir travailler si le fournisseur IA est indisponible.
Le contrat retenu est le suivant :
- le technicien déclenche l’analyse depuis le ticket ;
- le logiciel transmet le message et les extraits autorisés de la documentation, jamais l’ensemble du compte ;
- l’IA propose une catégorie, trois références documentaires et un brouillon ;
- le logiciel vérifie la catégorie, l’existence des références et la structure ;
- le technicien peut corriger ou refuser ; aucun message n’est envoyé par l’IA ;
- une priorité critique reste déterminée par les règles existantes ;
- en cas d’échec, le ticket et l’éditeur manuel restent disponibles ;
- la version du modèle, la version de la consigne, le résultat de validation et le motif de correction sont suivis selon une durée à définir.
L’équipe commence en mode miroir, puis ouvre le brouillon à un groupe limité. Elle n’envisagera l’envoi automatique que pour une catégorie simple, réversible et suffisamment observée. Ce choix produit moins d’effet en démonstration, mais il préserve les droits, le travail du technicien et la capacité de revenir en arrière.
Suivez la qualité, l’usage et l’exploitation
Après l’ouverture, surveillez quatre dimensions sans les réduire à un score unique :
- qualité : cas acceptés, corrigés ou refusés, gravité des erreurs et nouveaux cas limites ;
- usage : personnes exposées, déclenchements, abandons et retour au parcours manuel ;
- exploitation : délais, erreurs techniques, reprises, changements de modèle, de consigne ou de source ;
- coût : volume d’appels, consommation par tâche et anomalies de dépense.
La check-list de production de la CNIL demande notamment si les éléments utiles à une décision sont journalisés, si leur conservation est justifiée, si la qualité reste contrôlée et si les personnes peuvent réellement intervenir. Il ne s’agit pas de tout conserver : documentez ce qui aide à expliquer, corriger et sécuriser, puis limitez les données et leur durée.
Ces mesures disent si la fonctionnalité tient son contrat. Le calcul des gains, du temps de contrôle et de l’intérêt d’une généralisation mérite une analyse économique distincte.
Les questions à poser avant d’activer la fonctionnalité
Demandez à l’équipe ou au prestataire de répondre avec un écran, un test ou une procédure, pas seulement avec « c’est prévu » :
- quelle action exacte devient possible après la réponse de l’IA ;
- quelles habilitations sont appliquées avant l’envoi des données et avant l’action ;
- quels cas typiques, difficiles et interdits composent l’évaluation ;
- quelles versions du modèle, des consignes et des sources sont identifiables ;
- comment l’utilisateur refuse, corrige ou signale une sortie ;
- que voit-il lorsque le service est lent ou indisponible ;
- qui reçoit l’alerte, peut désactiver la fonction et connaît la procédure de retour arrière ;
- quelles données sont journalisées, pour quelle raison et pendant combien de temps.
Une réponse floue sur les permissions, le repli ou le responsable suffit à retarder l’automatisation. Elle n’empêche pas forcément un test hors ligne ou une assistance sans écriture.
Ce que Klaapp peut cadrer lors d’un premier échange
Klaapp accompagne l’intégration de l’IA dans un produit ou un outil existant. Un premier échange peut passer votre prototype au contrat en neuf champs, examiner les données et les droits disponibles, puis choisir le premier niveau d’exposition vérifiable. La recommandation peut être une assistance limitée, un chantier préalable sur l’existant ou l’arrêt du prototype si le mode d’échec reste inacceptable.
Questions fréquentes
Faut-il changer tout le logiciel pour intégrer l’IA ?
Non. Une couche d’intégration peut isoler l’appel au modèle et conserver les droits, règles et écritures dans le logiciel existant. Une refonte plus large devient pertinente seulement si les données, les accès ou le parcours actuel empêchent déjà de définir une frontière sûre.
Un contrôle humain rend-il l’intégration inutile ?
Non. Le contrôle humain peut porter uniquement sur les points que le logiciel ne sait pas valider. Il doit toutefois être prévu dans la charge réelle : si relire prend autant de temps que produire, la fonctionnalité doit être simplifiée, améliorée ou arrêtée.
Peut-on garantir qu’une IA ne se trompera pas ?
Non. On peut réduire, détecter et contenir des erreurs, puis décider lesquelles sont acceptables. Une promesse d’absence d’erreur est incompatible avec une sortie variable ; le système doit prévoir le refus et le repli.
Quand peut-on supprimer la validation humaine ?
Seulement pour une action bornée, réversible et suffisamment observée, lorsque des contrôles déterministes interceptent les cas interdits et qu’un retour arrière a été testé. Les décisions sensibles ou difficiles à corriger peuvent conserver une validation humaine durablement.
Sources
- NIST AI Resource Center — AI RMF Core
- CNIL — Garantir la sécurité du développement d’un système d’IA
- CNIL — Utiliser un système d’IA en production
- OpenAI Developers — Evaluation best practices
- OWASP GenAI Security Project — LLM06:2025 Excessive Agency
Thomas R. est cofondateur de Klaapp. Il porte les choix techniques et l’intégration de l’IA, puis relie les possibilités de la solution aux contraintes et aux objectifs du projet. Découvrir le studio Klaapp.